10/8/2026 • 5 min de lecture
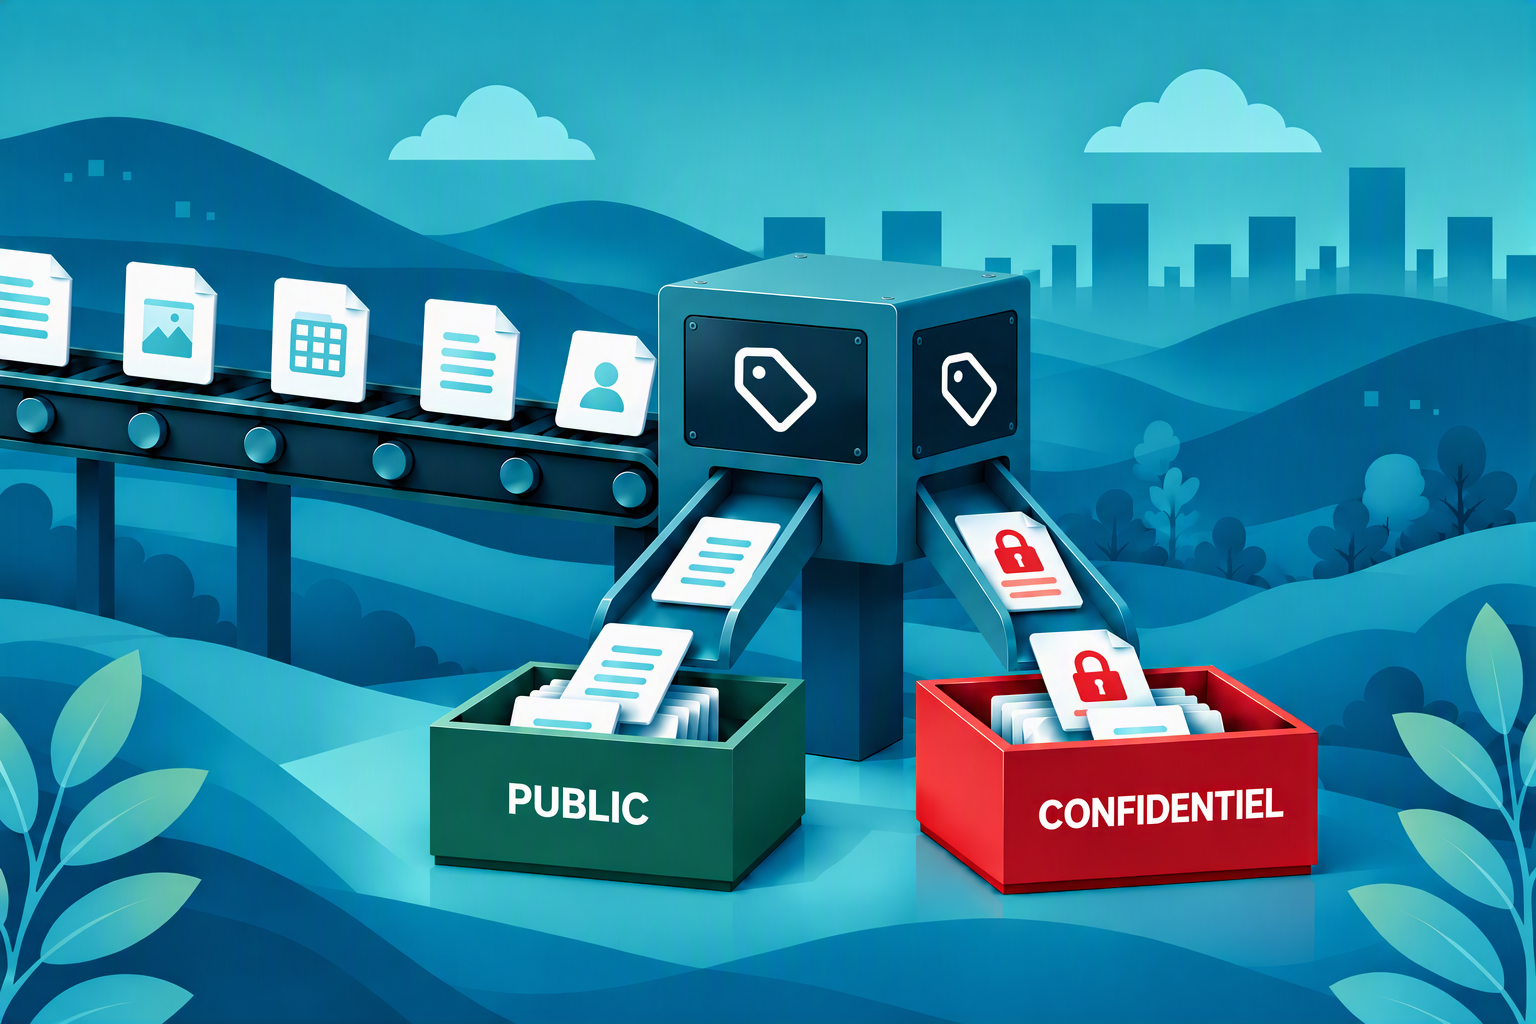
On ne protège bien que ce qu'on connaît. C'est le principe de base de la classification des données : identifier ce que l'organisation possède, comprendre sa sensibilité, et appliquer les bons contrôles au bon niveau. Sans classification, la sécurité s'applique à l'aveugle. Trop large, elle freine la productivité. Trop légère, elle laisse passer des fuites. Cet article explique pourquoi la classification est le préalable à toute stratégie de protection.
En 2024, 35 % des violations documentées par IBM impliquaient des données stockées dans des sources non gérées, ce que l’on appelle le « shadow data » (IBM, Cost of a Data Breach Report 2024). Ces données, dont l’existence ou la localisation échappe parfois aux équipes, créent mécaniquement un angle mort dans leur stratégie de protection.
La classification répond directement à ce problème. Selon le rapport Thales 2024, 70 % des entreprises ne sont capables de classifier que 50 % ou moins de leurs données. Une part importante des données circule, se copie, se partage et se stocke donc sans que leur niveau de sensibilité soit clairement identifié.
Le problème est aussi celui de l’échelle. Les volumes générés par une organisation moderne ne peuvent pas être traités document par document. La classification automatisée n’est pas une option de confort, mais une condition pour appliquer efficacement les politiques de sécurité à l’ensemble des données.
À retenir. Sans classification, il est impossible d’adapter le niveau de protection à la sensibilité des données.
Un schéma de classification n'a pas besoin d'être complexe pour être efficace. La plupart des organisations s'appuient sur quatre niveaux, recommandés notamment par l'ANSSI dans ses référentiels publiés en 2025.
Public : informations librement communicables, sans impact en cas de diffusion. Un communiqué de presse, une plaquette commerciale.
Interne : informations destinées aux collaborateurs, sans caractère sensible particulier mais sans vocation à sortir de l'organisation. Un organigramme, un compte rendu de réunion ordinaire.
Confidentiel : informations dont la divulgation non autorisée pourrait nuire à l'organisation. Données clients, contrats, informations financières non publiées, propriété intellectuelle.
Restreint : informations hautement sensibles dont la compromission aurait des conséquences graves. Données de santé, données réglementées, secrets industriels, données personnelles sensibles au sens du RGPD.
Un référentiel à quatre niveaux, bien compris par les équipes métier, vaut mieux qu'un référentiel à huit niveaux que personne n'applique. La complexité n'est pas un gage de rigueur : elle est souvent l'ennemi de l'adoption.
Au-delà de ces niveaux transverses, la classification peut aussi s'organiser par usage métier. Une équipe marketing classifiera ses données différemment d'une équipe RH ou d'une direction financière, non pas parce que leurs niveaux de sensibilité diffèrent fondamentalement, mais parce que les données elles-mêmes, leurs contextes d'utilisation et leurs risques associés sont distincts. Classifier par usage permet d'appliquer des politiques adaptées à chaque périmètre sans imposer un cadre uniforme qui ne correspond à aucun terrain réel.
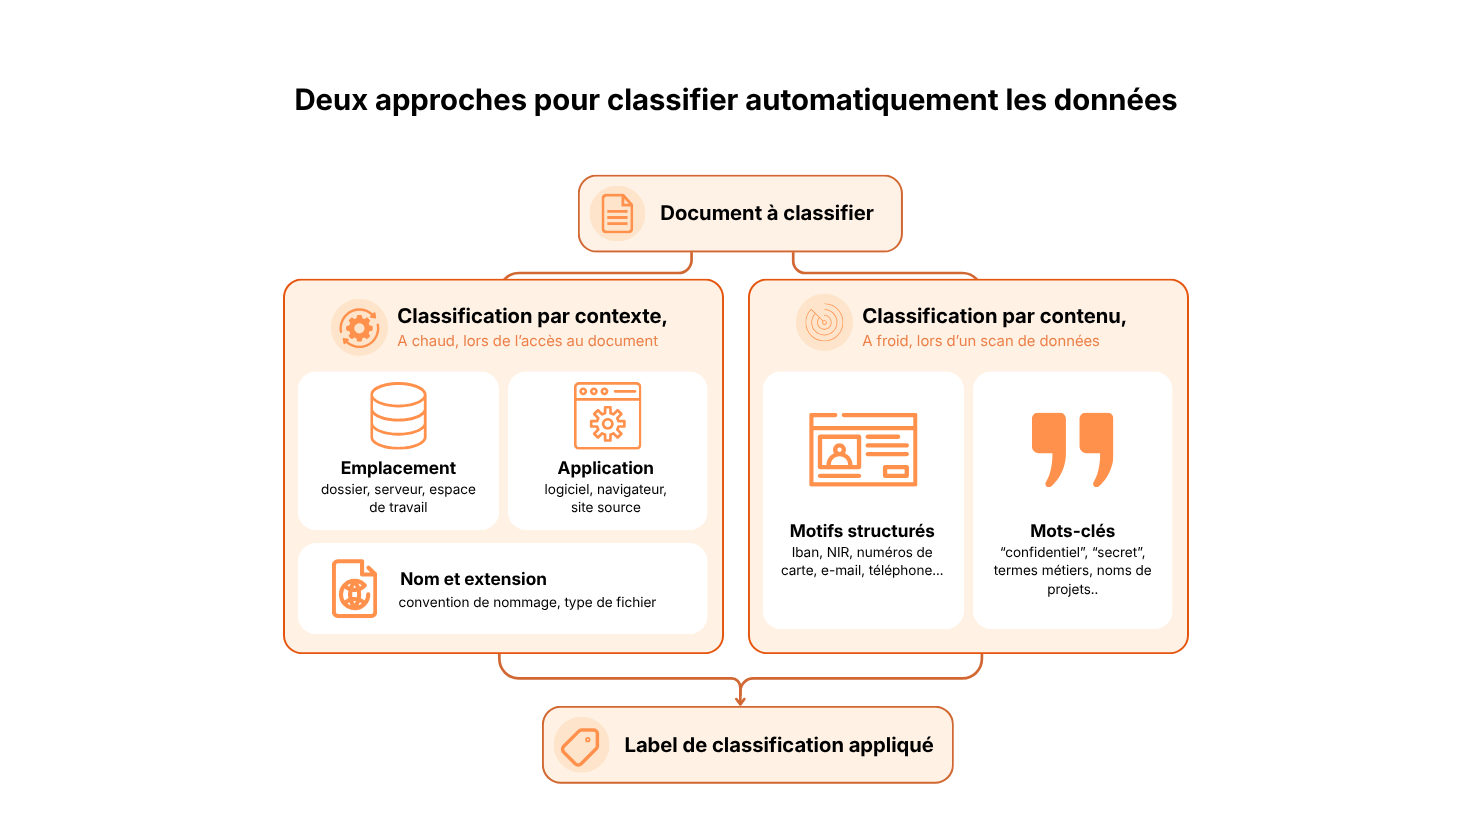
Attribuer un niveau de classification à un document peut se faire selon deux logiques complémentaires, qui répondent à des situations différentes.
La classification par contexte s'appuie sur des signaux indirects liés au document : où il se trouve, d'où il vient, comment il s'appelle, quelle extension il porte ou quelle application l'a créé.
Un document stocké dans le dossier "Contrats clients" sur le SharePoint de la direction juridique n'a pas besoin d'être lu pour être classifié "Confidentiel". Un fichier portant l'extension .xls sorti d'un logiciel de paie sera classé différemment d'un .xls généré par un tableur personnel. Un document téléchargé depuis l'espace extranet d'un cabinet d'avocats sera traité différemment d'un fichier issu d'un site institutionnel public.
Cette approche permet également de classifier les contenus issus de l’intelligence artificielle, qu’il s’agisse de documents, d’images ou de fichiers Excel, en fonction de leur provenance et de l’application qui les a générés. Elle contribue ainsi à la traçabilité des contenus générés par IA et au respect des exigences de transparence de l’AI Act.
La classification par contenu analyse le document lui-même : elle recherche des patterns, des expressions régulières, des mots-clés, des structures de données caractéristiques d'une information sensible.
Un numéro de sécurité sociale suit un format reconnaissable. Un IBAN aussi. Un document contenant des termes comme "secret de fabrication", "confidentiel" ou des données médicales structurées peut être détecté automatiquement.
En pratique, les deux approches se complètent. La classification par contexte traite rapidement les grands volumes et les cas évidents. La classification par contenu prend le relais sur les fichiers ambigus, mal nommés ou mal rangés, et sur les données sensibles qui ne se signalent pas par leur contexte.
La classification n'est pas une fin en soi. C'est le prérequis à d'autres mécanismes de sécurité qui ne peuvent pas fonctionner sans elle.
Une politique DLP sans classification revient à demander à un système de bloquer "les fichiers sensibles" sans lui dire ce que sensible signifie. Elle génère soit trop de faux positifs qui paralysent les équipes, soit trop de faux négatifs qui laissent passer les vrais risques. Avec une classification opérationnelle, les règles DLP deviennent précises : les documents classés "Restreint" ne peuvent pas être envoyés vers des domaines extérieurs, copiés sur un support amovible ou partagés via un outil SaaS non approuvé.
Le même raisonnement s'applique à la gestion des droits d'accès. Les données "Confidentiel" doivent être accessibles aux équipes qui en ont besoin, pas à l'ensemble de l'organisation. Sans label de classification, cette granularité est impossible à maintenir à l'échelle. Avec elle, les politiques d'accès s'appliquent automatiquement au niveau de la donnée, et non plus uniquement au niveau du dossier ou de l'application.
La classification permet également de répondre aux obligations réglementaires avec précision plutôt qu'avec excès. Le RGPD impose des mesures proportionnées à la sensibilité des données. NIS 2 exige la protection des informations critiques. Sans classification, la conformité se traduit souvent par une surprotection de tout, coûteuse et ingérable, ou par une sous-protection de ce qui compte vraiment.
La classification n’est pas un projet ponctuel. Les données bougent, se copient, se transforment et se partagent en permanence au sein du système d’information. Un document sensible peut être déplacé d’un serveur à un autre, copié sur un poste de travail ou partagé via un espace réseau.
Pour rester utile, la classification doit donc accompagner ces usages et ne pas dépendre uniquement de l’emplacement initial du fichier. L’objectif est de conserver une information de sensibilité cohérente lorsque la donnée circule dans l’environnement de l’organisation.
C’est précisément l’approche de Daspren : cartographier en continu les données sensibles, les classifier automatiquement selon leur contenu et leur contexte, puis maintenir cette classification lorsqu’elles circulent au sein des environnements supervisés. Une approche qui permet aux organisations de garder la maîtrise de leurs données sensibles, au-delà de leur emplacement.
Classifier ses données, c’est répondre à deux questions simples : qu’est-ce qu’on protège, et pourquoi ? Sans cette réponse, les outils de protection manquent de contexte. Avec elle, les contrôles d’accès, la DLP, ou encore la supervision peuvent être appliqués de manière plus précise et plus proportionnée.
À mesure que les volumes de données augmentent et que leurs usages se multiplient, cette capacité à les identifier, les comprendre et les traiter selon leur niveau de sensibilité devient un socle important pour construire une stratégie de protection cohérente.
Envie d'en savoir plus ? Contactez-nous dès aujourd'hui pour discutez de vos enjeux.